
Jak sprawdzić, czy model AI naprawdę rozumie polski kontekst kulturowy? Z odpowiedzią na to pytanie przychodzi PoVisLE – wizyjno-językowy benchmark stworzony przez Zakład Przetwarzania Języka Naturalnego NASK. To obrazowo-tekstowy sprawdzian złożony z 1117 obrazów oraz 2366 ręcznie opracowanych par pytań i odpowiedzi, które pozwalają ocenić, jak dobrze modele sztucznej inteligencji rozumieją treści wizualne oraz związane z nimi odniesienia językowe i kulturowe.
Rodzaje zadań
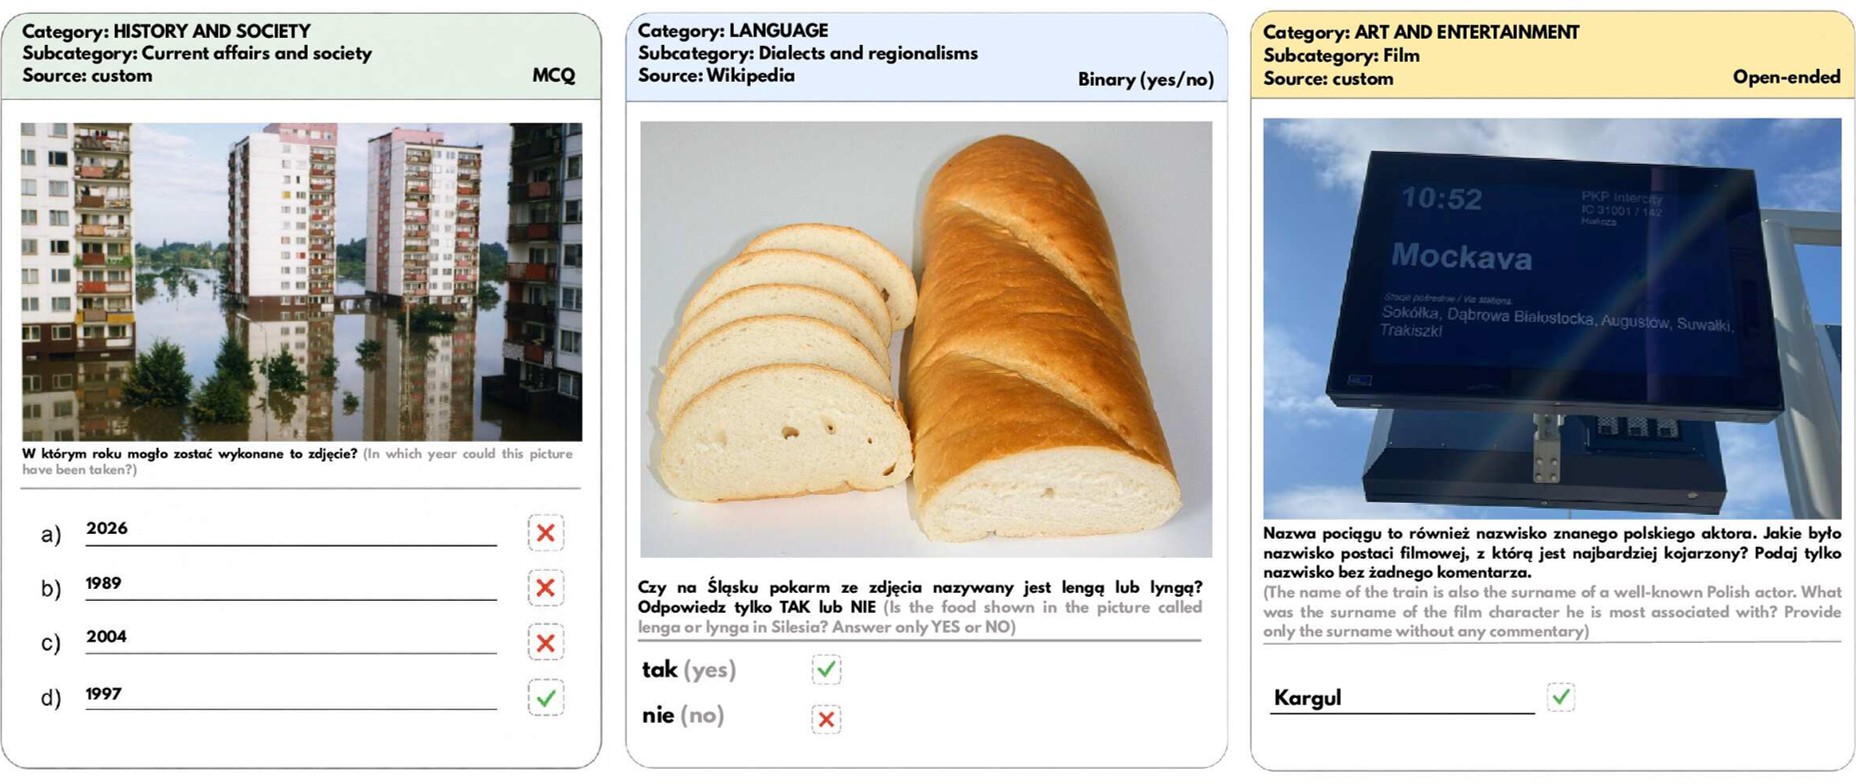
Pytania, na które model ma odpowiedzieć na podstawie obrazów, są podzielone na trzy kategorie: wielokrotnego wyboru, wymagające odpowiedzi „tak” lub „nie” oraz otwarte. Każde z nich zostało skonstruowane w taki sposób, aby sprawdzać rzeczywiste zrozumienie prezentowanej grafiki. Innymi słowy, poprawna odpowiedź powinna wynikać z analizy obrazu, a nie wyłącznie z wiedzy ogólnej modelu czy wskazówek tekstowych. Pod pytaniami wielokrotnego wyboru znajdują się opcje odpowiedzi oznaczone literami, spośród których model ma wskazać właściwą. Pytania typu „tak/nie” mają formę prostych stwierdzeń lub pytań ocenianych binarnie i nie zawierają dodatkowych opcji odpowiedzi. Podobnie działają pytania otwarte, gdzie jedyną wskazówką jest treść samego pytania, a odpowiedź trzeba sformułować na podstawie tego, co widać na obrazie.
Klasyfikacja
Punktem wyjścia dla klasyfikacji pytań był polski benchmark kulturowy PLCC. Choć został on opracowany z myślą o zadaniach tekstowych, jego struktura okazała się na tyle uniwersalna, że można było dostosować ją również do zadań wykorzystujących obrazy. W procesie modyfikacji kategorie gramatyka i słownictwo połączono w jedną kategorię nazwaną „język”. Dzięki takiemu podejściu możliwa jest bardziej kompleksowa ocena modeli, obejmująca nie tylko kompetencje językowe, lecz także zdolności rozumowania kulturowego oraz interpretacji treści wizualnych. Zbiór danych podzielony jest na następujące główne kategorie:
Tworzenie zbioru danych
Zbiór danych PoVisLE został stworzyliśmy ręcznie bez użycia sztywnych szablonów. Podczas tworzenia pytań wybieraliśmy lub weryfikowaliśmy obrazy pochodzące z serwisu Wikimedia Commons, innych ogólnodostępnych źródeł o odpowiednich licencjach oraz prywatnych zbiorów udostępnionych do celów badawczych. Do każdego obrazu przygotowaliśmy jedno lub więcej pytań w języku polskim, przypisując im odpowiedni typ zadania oraz kategorię tematyczną.
Aby zwiększyć różnorodność zbioru i ograniczyć ryzyko stronniczego doboru materiałów, uzupełniliśmy go dodatkowymi zasobami z Wikimedii. Każdy obraz i każde pytanie przechodziły następnie proces weryfikacji prowadzony przez lingwistów. Szczególną uwagę zwracaliśmy na to, by pytania wymagały rzeczywistego zrozumienia obrazu, były jednoznaczne i brzmiały naturalnie.
Na koniec podzieliliśmy zbiór na część testową, przeznaczoną do końcowej oceny modeli, oraz część walidacyjną, która prezentuje różnorodność dostępnych typów zadań. Dzięki temu PoVisLE jest nie tylko narzędziem ewaluacyjnym, ale także dobrym przykładem zakresu wyzwań, jakie stawia przed modelami polski kontekst wizualny i kulturowy.
Ewaluacja
Poddaliśmy ocenie 16 otwartych i komercyjnych modeli wizyjno-językowych, w tym modele z rodzin Qwen, Gemma, Mistral, GLM, LLaVA, GPT i Claude. Każdy z nich otrzymywał obrazy i pytania bez dodatkowych przykładów ani podpowiedzi związanych z polską kulturą. Modele działały w trybie, w którym nie wprowadzały losowości, dzięki czemu to samo pytanie i ten sam obraz zawsze prowadziły do tej samej odpowiedzi. Wynik końcowy obliczaliśmy jako średnią skuteczność dla poszczególnych typów pytań, dzięki czemu żaden z nich nie miał większego wpływu na rezultat tylko dlatego, że występował częściej.
W modelach wizyjno-językowych często występuje skłonność do częstszego wybierania odpowiedzi znajdujących się na określonej pozycji, niezależnie od ich treści. Aby ograniczyć wpływ tego zjawiska na wynik, w pytaniach wielokrotnego wyboru zmienialiśmy kolejność dostępnych opcji, a odpowiedź uznawaliśmy za poprawną tylko wtedy, gdy model wskazywał właściwą opcję przy każdym układzie. W przypadku pytań otwartych liczyła się nie tylko poprawność merytoryczna, ale również wymagany format oraz poprawność językowa odpowiedzi.
Wyniki
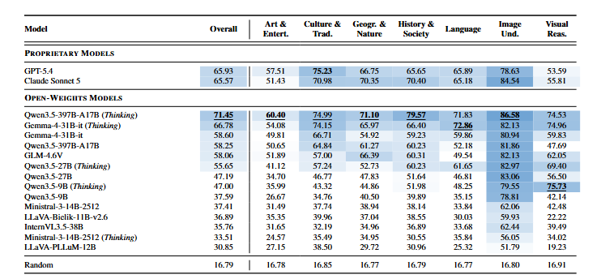
Najlepszy wynik uzyskał Qwen3.5-397B-A17B w trybie rozumowania (Thinking), osiągając 71,45% skuteczności. Wśród najlepiej ocenionych modeli znalazły się również Gemma-4-31B-it (Thinking) z wynikiem 66,78%, GPT-5.4 z 65,93% oraz Claude Sonnet 5 z 65,57%.
Najłatwiejszą kategorią dla wszystkich modeli było „Rozumienie obrazów”, czyli bezpośrednie rozpoznawanie i interpretacja treści wizualnych. Spośród kategorii związanych z polskim kontekstem kulturowym najtrudniejsza okazała się „Sztuka i rozrywka”, a na poziomie bardziej szczegółowych podkategorii najsłabsze wyniki dotyczyły dialektów i regionalizmów.
Znaczenie miał również typ pytania. Najlepiej modele radziły sobie z pytaniami „tak/nie”, natomiast większym wyzwaniem były odpowiedzi otwarte, w których trzeba było nie tylko podać właściwą informację, ale również zachować wymagany format i poprawną formę językową. W tego typu zadaniach najczęściej pojawiały się błędne, zmyślone odpowiedzi oraz problemy z przestrzeganiem instrukcji.
Czy pytania rzeczywiście wymagają analizy obrazu?
Aby sprawdzić, czy zadania rzeczywiście wymagają analizy obrazu, powtórzyliśmy część eksperymentów bez podawania informacji wizualnej. Po jej usunięciu ogólny wynik dla wiodących modeli spadł o 32-48 punktów procentowych. Największą różnicę zaobserwowano w pytaniach otwartych, gdzie skuteczność wyniosła zaledwie 1–12%, oraz w pytaniach wielokrotnego wyboru, gdzie spadła do 4–29%. Wyniki pokazują, że sama treść pytania w większości przypadków nie wystarcza do udzielenia poprawnej odpowiedzi.
Przeanalizowaliśmy również scenariusz odwrotny, w którym pokazaliśmy modelowi obraz (oraz opcje w przypadku pytań wielokrotnego wyboru), ale usunęliśmy pytanie. W zadaniach otwartych skuteczność spadła wówczas do zera, a w pytaniach „tak/nie” utrzymała się na poziomie zbliżonym do losowego wyboru. W pytaniach wielokrotnego wyboru wyniki były wyższe, co sugeruje, że w niektórych przypadkach sam obraz w połączeniu z dostępnymi opcjami dostarczał wystarczających wskazówek do wskazania właściwej odpowiedzi.
Rozumowanie oraz język pytania
Tryby rozszerzonego rozumowania (Thinking) wyraźnie pomagały większości testowanych modeli. W przypadku najmocniejszego Qwen3.5-397B-A17B wynik wzrósł o ponad 13 punktów procentowych. Największą poprawę widać było w zadaniach wymagających rozumowania wizualnego, znajomości języka oraz historii i społeczeństwa. Dużą poprawę odnotowała też Gemma-4-31B-it, która zyskała ponad 8 punktów procentowych i osiągnęła najlepsze wyniki w kategoriach „Język” oraz „Rozumowanie wizualne”.
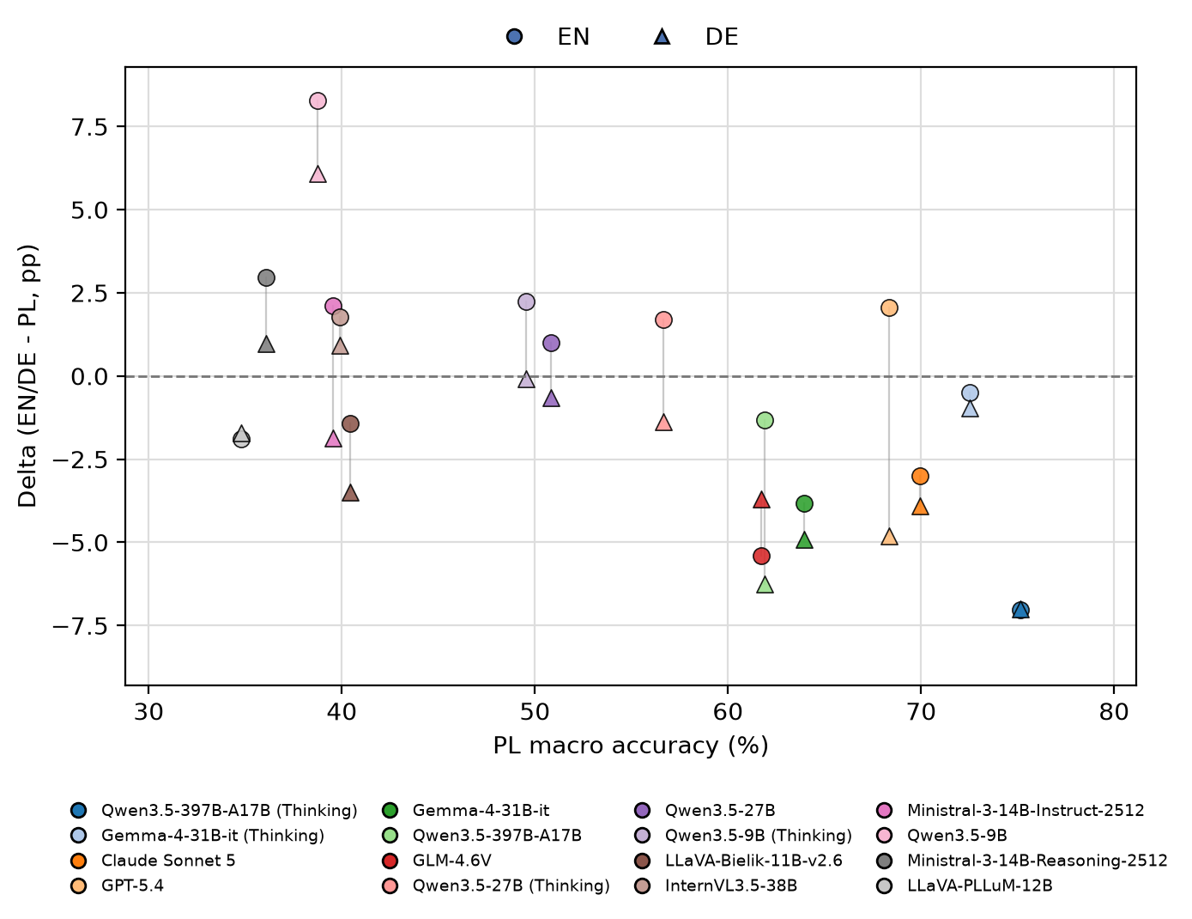
Znaczenie miał również język, w którym zadawaliśmy pytanie. Na próbce 465 zadań porównaliśmy polskie wersje z tłumaczeniami na angielski i niemiecki. Najmocniejsze modele zazwyczaj radziły sobie najlepiej z oryginalnymi pytaniami po polsku. Z kolei część słabszych modeli poprawiała wyniki po przejściu na angielski, co może wynikać z większej ilości anglojęzycznych danych używanych podczas ich trenowania.
Era benchmarków szytych na miarę języka i kultury
PoVisLE pokazuje, że ocena modeli AI nie może ograniczać się wyłącznie do ogólnych benchmarków czy zadań w języku angielskim. Rzeczywiste zrozumienie lokalnego kontekstu kulturowego, językowego i wizualnego pozostaje dla wielu systemów znaczącym wyzwaniem, nawet jeśli osiągają one wysokie wyniki w innych testach. Wyniki uzyskane w PoVisLE potwierdzają, że skuteczne rozwiązywanie tego typu zadań wymaga jednoczesnego analizowania obrazu, interpretowania treści pytania oraz odwoływania się do wiedzy o Polsce. Benchmark stanowi więc nie tylko narzędzie do porównywania modeli, lecz także cenne źródło informacji o ich mocnych i słabych stronach. Wraz z rozwojem wielomodalnych systemów AI takie wyspecjalizowane, lokalnie osadzone testy będą odgrywać coraz większą rolę w ocenie jakości modeli i ich gotowości do działania w konkretnych realiach językowych i kulturowych.
Rodzaje zadań
Pytania, na które model ma odpowiedzieć na podstawie obrazów, są podzielone na trzy kategorie: wielokrotnego wyboru, wymagające odpowiedzi „tak” lub „nie” oraz otwarte. Każde z nich zostało skonstruowane w taki sposób, aby sprawdzać rzeczywiste zrozumienie prezentowanej grafiki. Innymi słowy, poprawna odpowiedź powinna wynikać z analizy obrazu, a nie wyłącznie z wiedzy ogólnej modelu czy wskazówek tekstowych. Pod pytaniami wielokrotnego wyboru znajdują się opcje odpowiedzi oznaczone literami, spośród których model ma wskazać właściwą. Pytania typu „tak/nie” mają formę prostych stwierdzeń lub pytań ocenianych binarnie i nie zawierają dodatkowych opcji odpowiedzi. Podobnie działają pytania otwarte, gdzie jedyną wskazówką jest treść samego pytania, a odpowiedź trzeba sformułować na podstawie tego, co widać na obrazie.
Klasyfikacja
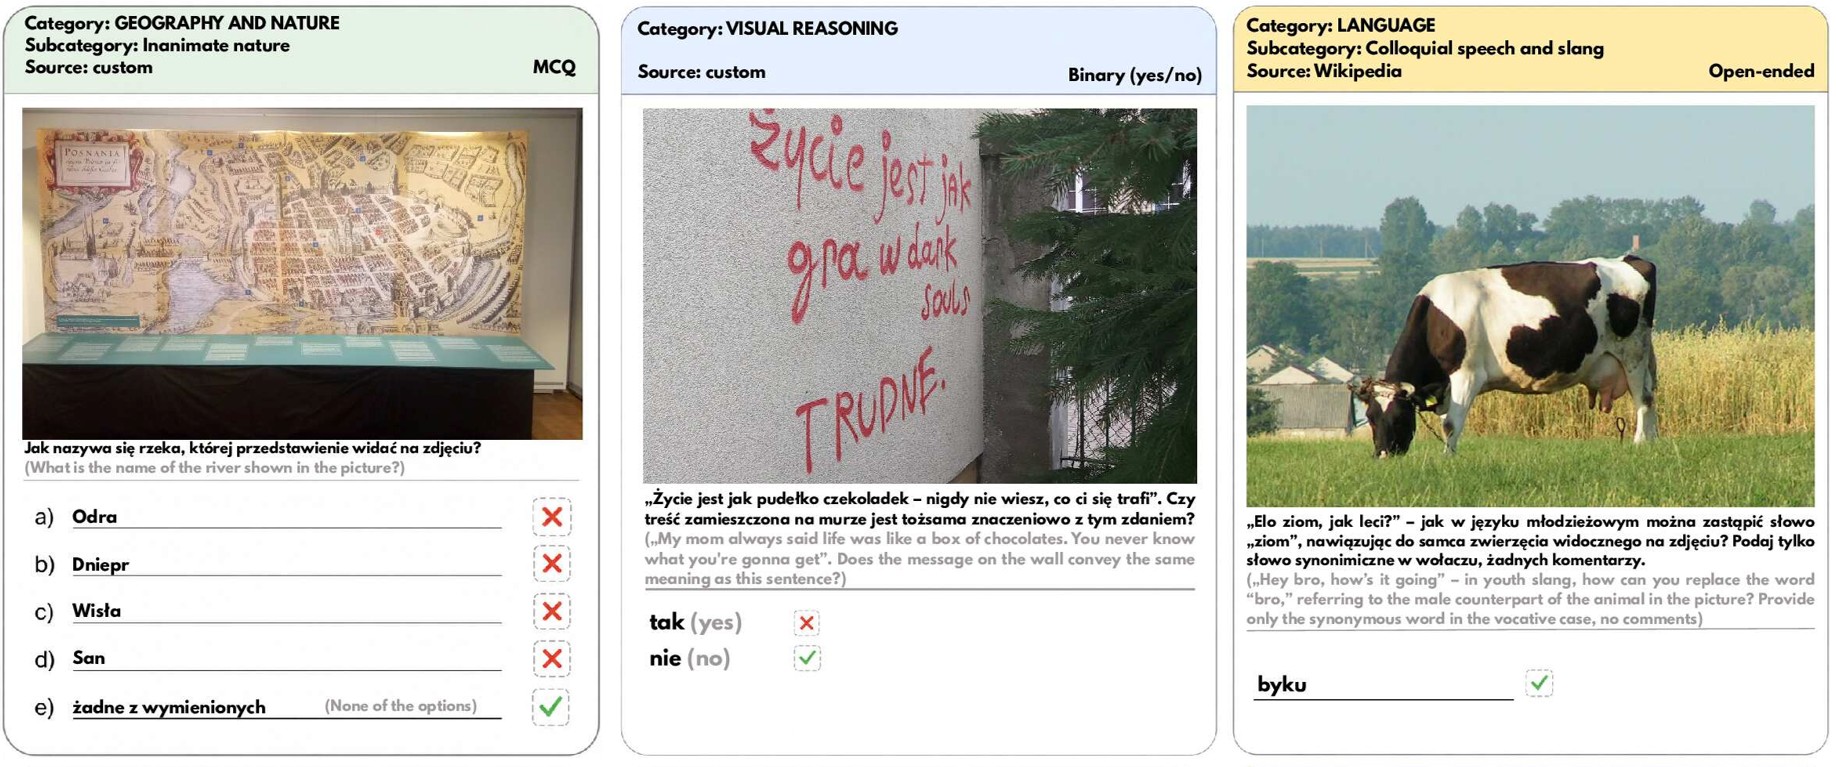
Punktem wyjścia dla klasyfikacji pytań był polski benchmark kulturowy PLCC. Choć został on opracowany z myślą o zadaniach tekstowych, jego struktura okazała się na tyle uniwersalna, że można było dostosować ją również do zadań wykorzystujących obrazy. W procesie modyfikacji kategorie gramatyka i słownictwo połączono w jedną kategorię nazwaną „język”. Dzięki takiemu podejściu możliwa jest bardziej kompleksowa ocena modeli, obejmująca nie tylko kompetencje językowe, lecz także zdolności rozumowania kulturowego oraz interpretacji treści wizualnych. Zbiór danych podzielony jest na następujące główne kategorie:
- - „Sztuka i rozrywka” skupia się na szeroko rozumianej polskiej kulturze. Obejmuje zarówno historyczne, jak i współczesne odniesienia do architektury, filmu, literatury, muzyki, malarstwa, rzeźby, sportu czy mediów.
- - „Kultura i tradycja” zawiera pytania o zwyczaje, praktyki, symbole, kuchnię, religię, tradycje, popkulturę oraz regionalne lub etniczne różnice kulturowe związane z Polską.
- - „Geografia i przyroda” to kategoria, w której pytamy o miejsca w Polsce, obiekty naturalne, miejskie, infrastrukturalne i kwestie społeczno-polityczne, w tym również krajobrazy, zabytki, regiony i jednostki administracyjne.
- - „Historia i społeczeństwo” składa się z historycznego i współczesnego kontekstu społecznego Polski; zawiera pytania o okresy historyczne takie jak średniowiecze, II wojna światowa, historia powojenna oraz bieżące wydarzenia.
- - „Język” obejmuje różnorodne aspekty polszczyzny widoczne w materiałach wizualnych. Znajdują się tu zarówno przykłady mowy potocznej, slangu, dialektów i regionalizmów, jak i zagadnienia związane z gramatyką, ortografią czy znaczeniem słów i wyrażeń.
- - „Rozumienie obrazów” koncentruje się na bezpośrednim rozpoznawaniu i interpretacji treści wizualnych związanych z Polską.
- - „Rozumowanie wizualne” to relacje, konteksty i informacje wywnioskowane na podstawie obrazu.
Tworzenie zbioru danych
Zbiór danych PoVisLE został stworzyliśmy ręcznie bez użycia sztywnych szablonów. Podczas tworzenia pytań wybieraliśmy lub weryfikowaliśmy obrazy pochodzące z serwisu Wikimedia Commons, innych ogólnodostępnych źródeł o odpowiednich licencjach oraz prywatnych zbiorów udostępnionych do celów badawczych. Do każdego obrazu przygotowaliśmy jedno lub więcej pytań w języku polskim, przypisując im odpowiedni typ zadania oraz kategorię tematyczną.
Aby zwiększyć różnorodność zbioru i ograniczyć ryzyko stronniczego doboru materiałów, uzupełniliśmy go dodatkowymi zasobami z Wikimedii. Każdy obraz i każde pytanie przechodziły następnie proces weryfikacji prowadzony przez lingwistów. Szczególną uwagę zwracaliśmy na to, by pytania wymagały rzeczywistego zrozumienia obrazu, były jednoznaczne i brzmiały naturalnie.
Na koniec podzieliliśmy zbiór na część testową, przeznaczoną do końcowej oceny modeli, oraz część walidacyjną, która prezentuje różnorodność dostępnych typów zadań. Dzięki temu PoVisLE jest nie tylko narzędziem ewaluacyjnym, ale także dobrym przykładem zakresu wyzwań, jakie stawia przed modelami polski kontekst wizualny i kulturowy.
Ewaluacja
Poddaliśmy ocenie 16 otwartych i komercyjnych modeli wizyjno-językowych, w tym modele z rodzin Qwen, Gemma, Mistral, GLM, LLaVA, GPT i Claude. Każdy z nich otrzymywał obrazy i pytania bez dodatkowych przykładów ani podpowiedzi związanych z polską kulturą. Modele działały w trybie, w którym nie wprowadzały losowości, dzięki czemu to samo pytanie i ten sam obraz zawsze prowadziły do tej samej odpowiedzi. Wynik końcowy obliczaliśmy jako średnią skuteczność dla poszczególnych typów pytań, dzięki czemu żaden z nich nie miał większego wpływu na rezultat tylko dlatego, że występował częściej.
W modelach wizyjno-językowych często występuje skłonność do częstszego wybierania odpowiedzi znajdujących się na określonej pozycji, niezależnie od ich treści. Aby ograniczyć wpływ tego zjawiska na wynik, w pytaniach wielokrotnego wyboru zmienialiśmy kolejność dostępnych opcji, a odpowiedź uznawaliśmy za poprawną tylko wtedy, gdy model wskazywał właściwą opcję przy każdym układzie. W przypadku pytań otwartych liczyła się nie tylko poprawność merytoryczna, ale również wymagany format oraz poprawność językowa odpowiedzi.
Wyniki
Najlepszy wynik uzyskał Qwen3.5-397B-A17B w trybie rozumowania (Thinking), osiągając 71,45% skuteczności. Wśród najlepiej ocenionych modeli znalazły się również Gemma-4-31B-it (Thinking) z wynikiem 66,78%, GPT-5.4 z 65,93% oraz Claude Sonnet 5 z 65,57%.
Najłatwiejszą kategorią dla wszystkich modeli było „Rozumienie obrazów”, czyli bezpośrednie rozpoznawanie i interpretacja treści wizualnych. Spośród kategorii związanych z polskim kontekstem kulturowym najtrudniejsza okazała się „Sztuka i rozrywka”, a na poziomie bardziej szczegółowych podkategorii najsłabsze wyniki dotyczyły dialektów i regionalizmów.
Znaczenie miał również typ pytania. Najlepiej modele radziły sobie z pytaniami „tak/nie”, natomiast większym wyzwaniem były odpowiedzi otwarte, w których trzeba było nie tylko podać właściwą informację, ale również zachować wymagany format i poprawną formę językową. W tego typu zadaniach najczęściej pojawiały się błędne, zmyślone odpowiedzi oraz problemy z przestrzeganiem instrukcji.
Czy pytania rzeczywiście wymagają analizy obrazu?
Aby sprawdzić, czy zadania rzeczywiście wymagają analizy obrazu, powtórzyliśmy część eksperymentów bez podawania informacji wizualnej. Po jej usunięciu ogólny wynik dla wiodących modeli spadł o 32-48 punktów procentowych. Największą różnicę zaobserwowano w pytaniach otwartych, gdzie skuteczność wyniosła zaledwie 1–12%, oraz w pytaniach wielokrotnego wyboru, gdzie spadła do 4–29%. Wyniki pokazują, że sama treść pytania w większości przypadków nie wystarcza do udzielenia poprawnej odpowiedzi.
Przeanalizowaliśmy również scenariusz odwrotny, w którym pokazaliśmy modelowi obraz (oraz opcje w przypadku pytań wielokrotnego wyboru), ale usunęliśmy pytanie. W zadaniach otwartych skuteczność spadła wówczas do zera, a w pytaniach „tak/nie” utrzymała się na poziomie zbliżonym do losowego wyboru. W pytaniach wielokrotnego wyboru wyniki były wyższe, co sugeruje, że w niektórych przypadkach sam obraz w połączeniu z dostępnymi opcjami dostarczał wystarczających wskazówek do wskazania właściwej odpowiedzi.
Rozumowanie oraz język pytania
Tryby rozszerzonego rozumowania (Thinking) wyraźnie pomagały większości testowanych modeli. W przypadku najmocniejszego Qwen3.5-397B-A17B wynik wzrósł o ponad 13 punktów procentowych. Największą poprawę widać było w zadaniach wymagających rozumowania wizualnego, znajomości języka oraz historii i społeczeństwa. Dużą poprawę odnotowała też Gemma-4-31B-it, która zyskała ponad 8 punktów procentowych i osiągnęła najlepsze wyniki w kategoriach „Język” oraz „Rozumowanie wizualne”.
Znaczenie miał również język, w którym zadawaliśmy pytanie. Na próbce 465 zadań porównaliśmy polskie wersje z tłumaczeniami na angielski i niemiecki. Najmocniejsze modele zazwyczaj radziły sobie najlepiej z oryginalnymi pytaniami po polsku. Z kolei część słabszych modeli poprawiała wyniki po przejściu na angielski, co może wynikać z większej ilości anglojęzycznych danych używanych podczas ich trenowania.
Era benchmarków szytych na miarę języka i kultury
PoVisLE pokazuje, że ocena modeli AI nie może ograniczać się wyłącznie do ogólnych benchmarków czy zadań w języku angielskim. Rzeczywiste zrozumienie lokalnego kontekstu kulturowego, językowego i wizualnego pozostaje dla wielu systemów znaczącym wyzwaniem, nawet jeśli osiągają one wysokie wyniki w innych testach. Wyniki uzyskane w PoVisLE potwierdzają, że skuteczne rozwiązywanie tego typu zadań wymaga jednoczesnego analizowania obrazu, interpretowania treści pytania oraz odwoływania się do wiedzy o Polsce. Benchmark stanowi więc nie tylko narzędzie do porównywania modeli, lecz także cenne źródło informacji o ich mocnych i słabych stronach. Wraz z rozwojem wielomodalnych systemów AI takie wyspecjalizowane, lokalnie osadzone testy będą odgrywać coraz większą rolę w ocenie jakości modeli i ich gotowości do działania w konkretnych realiach językowych i kulturowych.